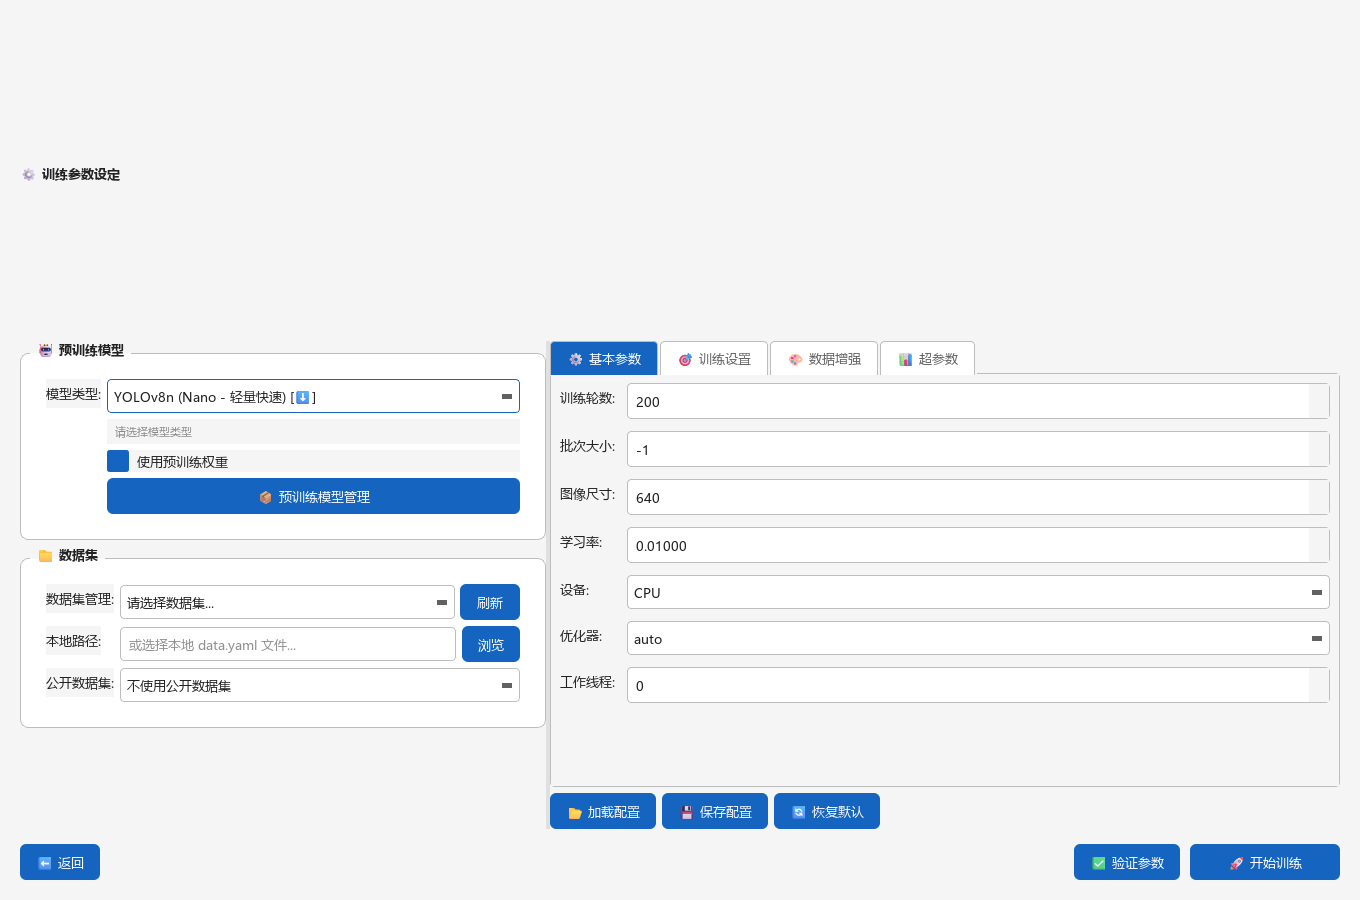
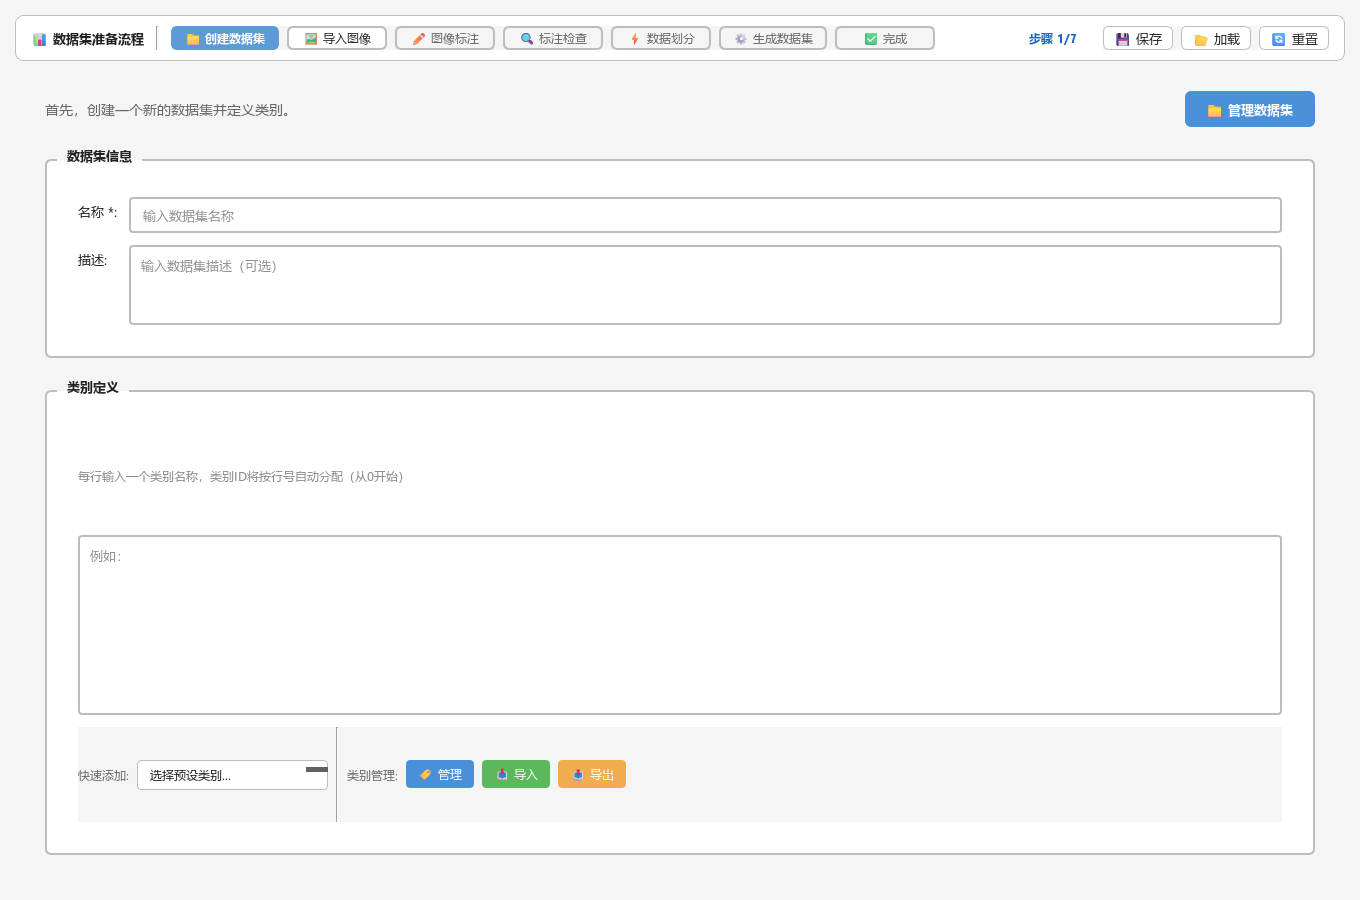
拿到训练权重后,我会先用一张固定图片建立推理基线,再尝试导出和接口封装。这个顺序能把模型问题、格式转换问题与服务调用问题分开。配套工作台分别提供推理、导出和部署组件,也为按实际业务扩展功能留下了相对清晰的入口。
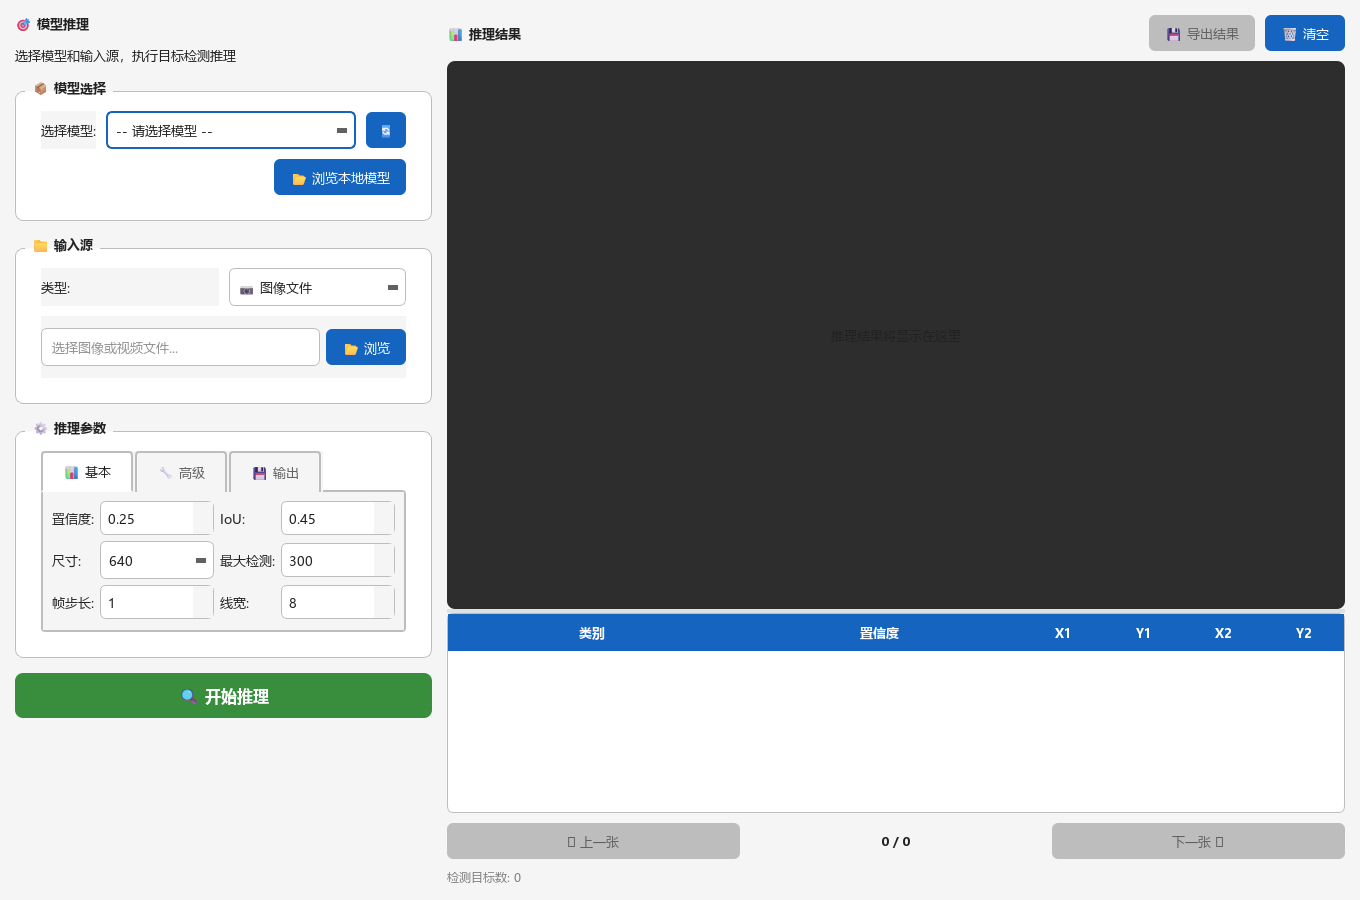
1. 用固定图片建立可复核的推理基线
准备一张自己理解标注结果的测试图片,记录模型版本、图片尺寸、置信度阈值和设备。先核对类别、检测框与显示坐标,再比较不同参数的结果。下面是与推理模块调用思路一致的最小示例,路径需要替换成自己的实验输出。
这段代码针对检测框结果。分割或姿态任务还需要读取对应的数据结构,不能把 result.boxes 当作所有任务的统一输出。
from ultralytics import YOLO

model = YOLO('runs/train/smoke_test/weights/best.pt')
results = model.predict(
    source='samples/test.jpg',
    imgsz=320,
    conf=0.25,
    device='cpu',
)
for result in results:
    if result.boxes is not None:
        print(result.boxes.xyxy.cpu().tolist())
        print(result.boxes.conf.cpu().tolist())
        print(result.boxes.cls.cpu().tolist())
2. 输出类别与坐标要约定清楚
当前推理组件将检测结果整理为类别编号、类别名称、置信度和 bbox,坐标来自 xyxy。做二次开发时,应明确框坐标对应原图还是缩放后的画面,并在显示端执行一致的坐标换算。
视频和摄像头还要考虑帧序号、时间戳、队列长度与界面刷新频率。模型推理不宜长时间占用 GUI 主线程;保留后台任务与界面信号之间的边界,有助于后续扩展批量处理、自动标注或其他输入源。
3. 导出先选一种目标格式完成验证
导出组件会检查各格式依赖,再调用模型的 export 方法。缺少运行时或目标环境不支持时,某个格式可能被跳过或失败;出现格式选项不等于所有机器都具备导出能力。
例如,准备使用 ONNX 时,先按目标环境安装相应依赖,再导出一个模型。导出文件存在后,还应在目标运行时加载它,并用同一张图片比较输入尺寸、归一化、类别映射、后处理和输出坐标。格式转换成功不自动等于预测一致或速度更快。
from ultralytics import YOLO

model = YOLO('runs/train/smoke_test/weights/best.pt')
exported = model.export(format='onnx', imgsz=320)
print('Exported model:', exported)
4. 本地 API 要把依赖、端口和请求形式对齐
部署组件包含生成本地 FastAPI 服务脚本并启动子进程的逻辑,提供 /health 和使用文件上传的 /predict 入口。测试时先准备 FastAPI、Uvicorn 和 python-multipart,选择有效模型,并在页面确认监听地址和端口。
如果在页面设置为 127.0.0.1:8000,可以按下面的方式检查健康接口和图片上传。请求采用 multipart 文件字段 file;把图片路径当作普通 JSON 字符串发送,与这个接口约定不同。
curl.exe http://127.0.0.1:8000/health
curl.exe -F "file=@samples/test.jpg" http://127.0.0.1:8000/predict
5. 按业务扩展时,从稳定的接口约定开始
建议先将模型加载、输入处理、推理调用和结果序列化拆开,再根据业务增加模型切换、批量任务、人工复核或自动标注。模型尽量复用,避免每张图片都重新初始化;失败结果应有明确错误信息,并能与对应输入关联。
现有本地服务是学习和联调起点。需要用于多人或远程访问时,还应补充身份认证、文件大小限制、并发控制、超时和日志策略。边缘转换与部分自动标注入口仍待完善,支持按实际需求二次开发;具体目标硬件和导出格式应分别验收。
对应源码模块与配套项目
本文结合本次整理源码编写,主要对应:gui/widgets/inference_widget.py、gui/widgets/export_widget.py、gui/widgets/deploy_widget.py。
项目介绍、界面截图与资料清单:桌面视觉模型训练与推理一体化工作台。