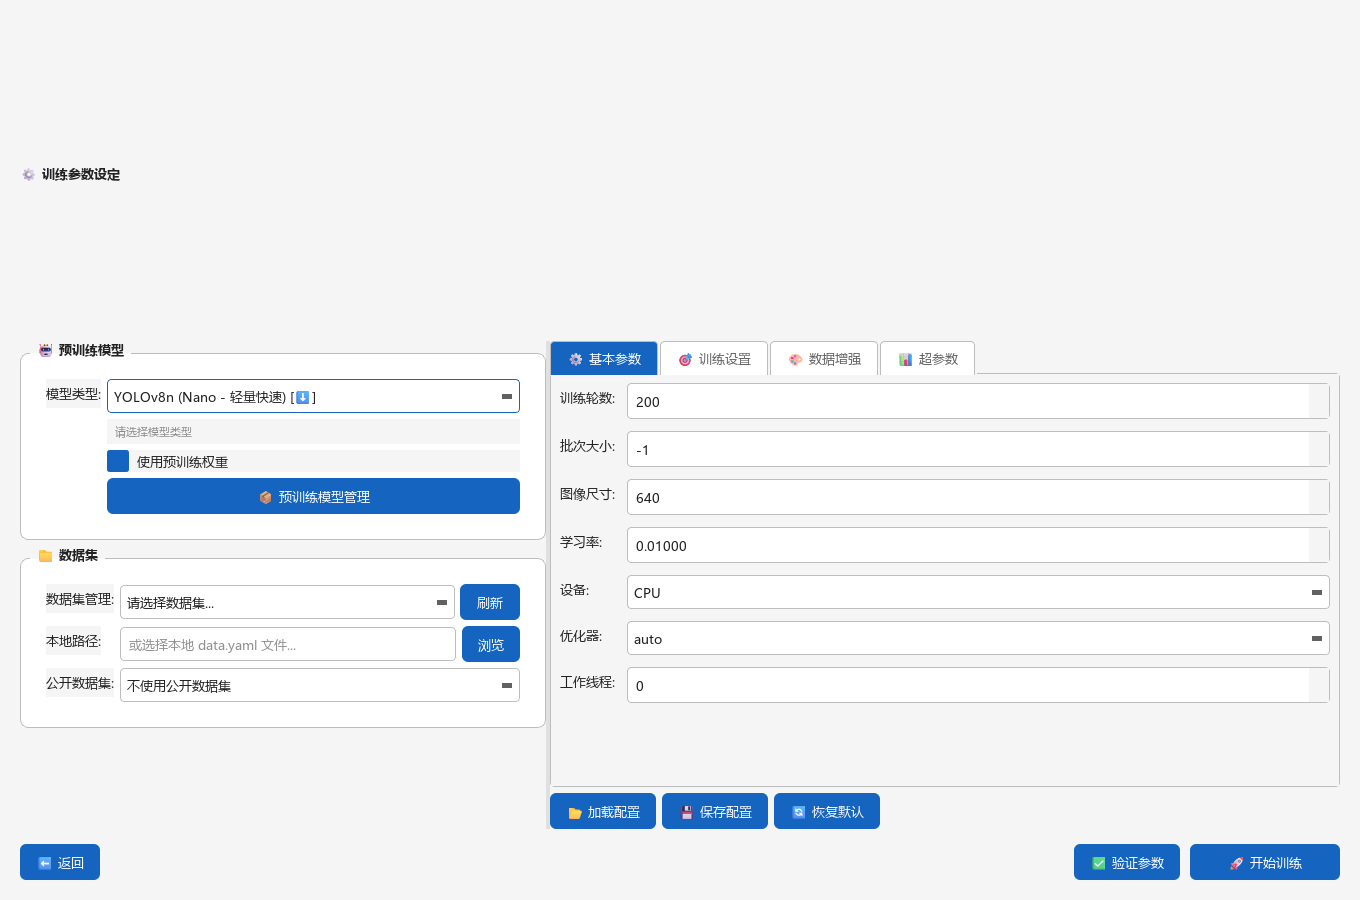
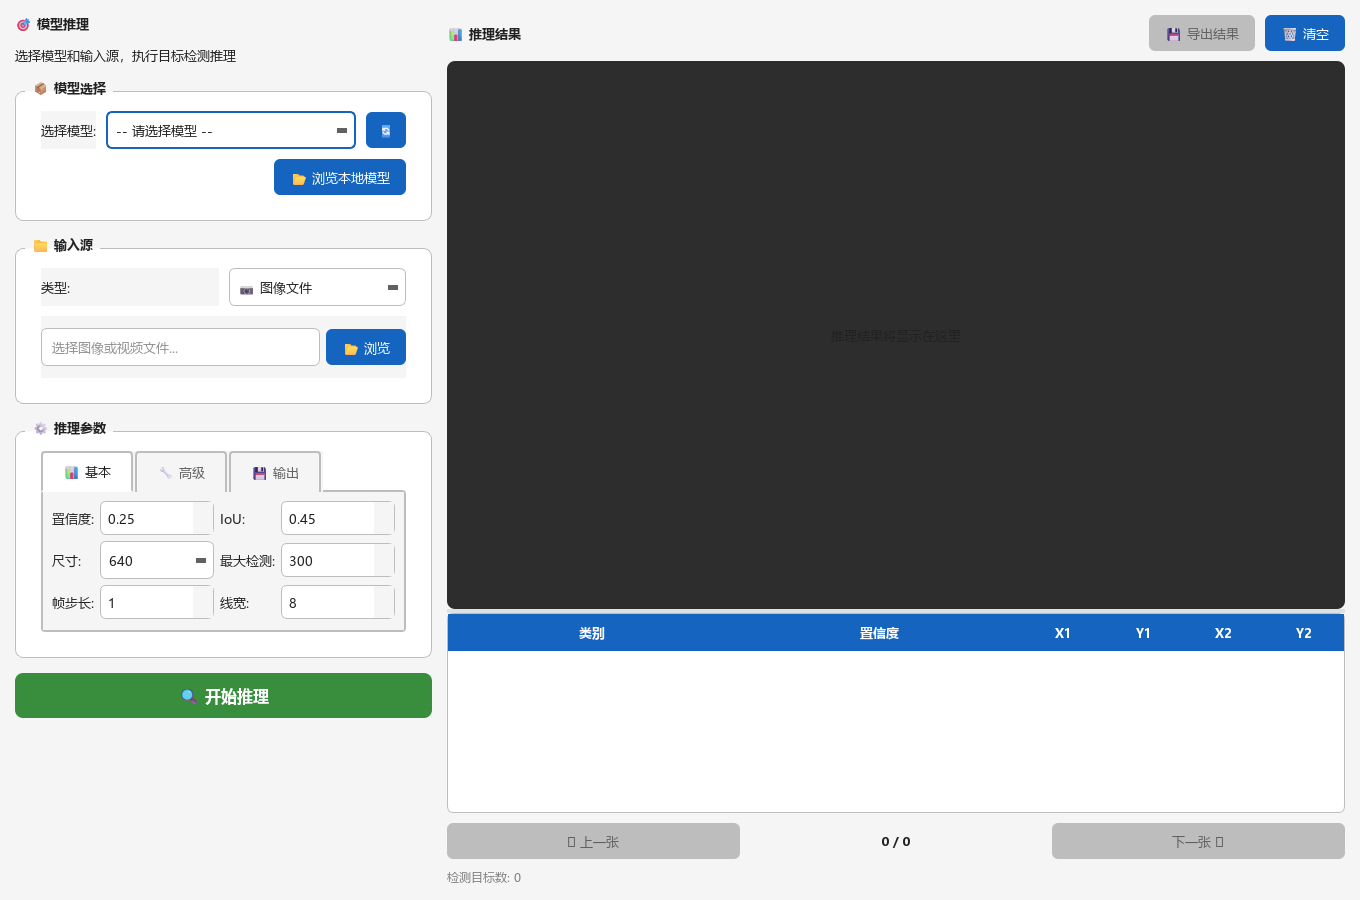
训练参数再丰富,也无法补救类别映射错位、图片与标签不匹配等问题。我通常把数据集检查放在调模型之前:先让一张图片、一条标签和一份配置能够互相对应,再扩大数据量。配套工作台提供了数据集流程界面,下面结合它的目录管理和 YAML 生成代码,说明一份可以交给训练模块的数据资料应该长什么样。
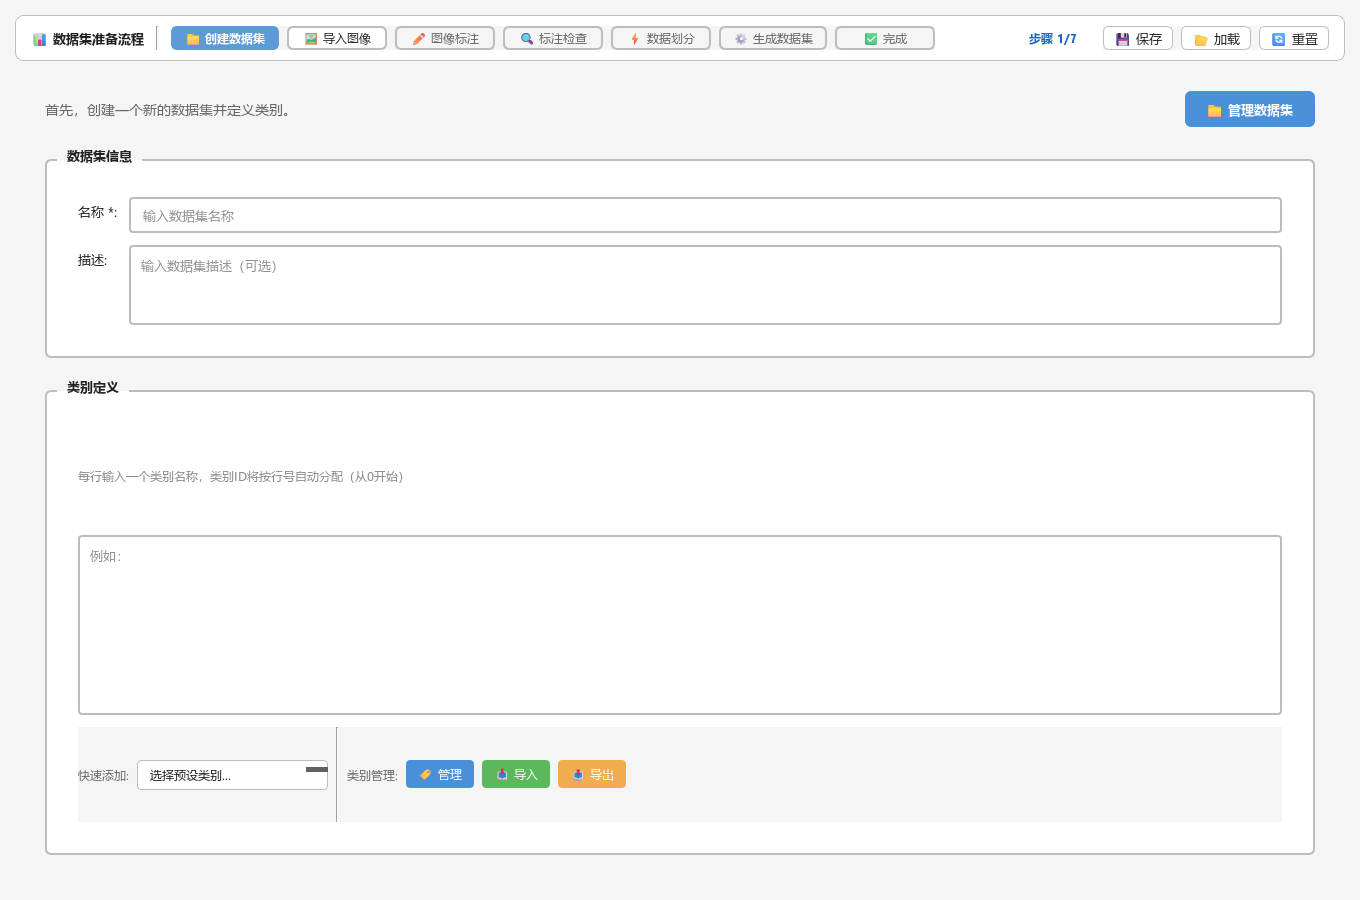
1. 明确项目元数据与训练资料的区别
DatasetManager 创建数据集时,会保存 dataset_info.json,并建立 images、labels、annotations、versions 等目录。这些内容用于工作台管理和版本记录。最终生成训练资料时,工作流还会组织拆分后的图片、标签及 data.yaml。
不能只复制一个名称相同的目录就认为数据集迁移完成。还要确认元数据中的路径、类别列表以及训练配置实际指向的位置,尤其是从别的机器迁移后留下的绝对路径。
2. 类别编号一旦开始标注,就要保持稳定
YOLO 检测标签中的第一列是类别编号,编号从 0 开始。例如,类别表中 0 对应 person、1 对应 helmet,那么所有标签都必须沿用这个映射。中途调整类别名称的顺序,会让同一个数字被解释成另一种目标。
下面是一条检测框示例。中心点和宽高均按图像尺寸归一化;它用于说明格式,不能代替分割、多边形或关键点任务各自的标签规范。
# class_id center_x center_y width height
0 0.500000 0.500000 0.200000 0.300000
3. 在拆分前检查图片、标签和目标范围
工作流源码包含对归一化坐标范围的检查。对学习实验来说,可以先采用手动标注和检查作为基线;计划加入 AI 辅助标注时,应核实相应入口的实际实现,并为自动结果保留人工复核步骤。
- 确认图片能正常解码,并检查空白图片、重复图片和异常尺寸。
- 核对图片与标签的文件名映射,区分有意保留的负样本与意外缺少标签的样本。
- 检查类别编号是否存在,坐标是否有效,检测框是否超出图像边界。
- 先预览一小批标注叠加结果,再执行批量生成;不要只依据标签文件存在就认定标注正确。
4. 训练集与验证集要尽量反映真实差异
界面的默认拆分比例为训练 70%、验证 20%、测试 10%,实际比例应结合样本规模和任务目标调整。比例本身不是关键,关键是避免同一段视频的相邻帧或同一拍摄对象的大量近重复图片同时进入训练集和验证集。
如果需要按视频、拍摄批次或场景分组拆分,应先准备好分组方案,并确认当前流程是否满足要求;不要直接把逐张随机拆分的结果当作独立场景评估。保留拆分清单,后续比较模型时尽量复用同一份验证集。
5. 核对生成后的 data.yaml,再交给训练模块
当前工作流生成器使用 train/images、val/images,存在测试集时再加入 test/images,并写入 nc 与编号到名称的映射。下面展示两类别数据的配置结构;路径是示例,应替换成自己的输出目录。
源码会将数据目录解析为绝对路径。因此目录搬家后,旧 data.yaml 不会自动跟着变化。重新生成或核对路径后,再确认训练页选择的是新配置。完成这一轮检查,才能把训练失败与数据路径错误区分开。
train: D:/vision-data/demo/train/images
val: D:/vision-data/demo/val/images
test: D:/vision-data/demo/test/images
nc: 2
names:
  0: person
  1: helmet
对应源码模块与配套项目
本文结合本次整理源码编写,主要对应:data/dataset_manager.py、data/formats.py、gui/widgets/dataset_workflow_widget.py。
项目介绍、界面截图与资料清单:桌面视觉模型训练与推理一体化工作台。