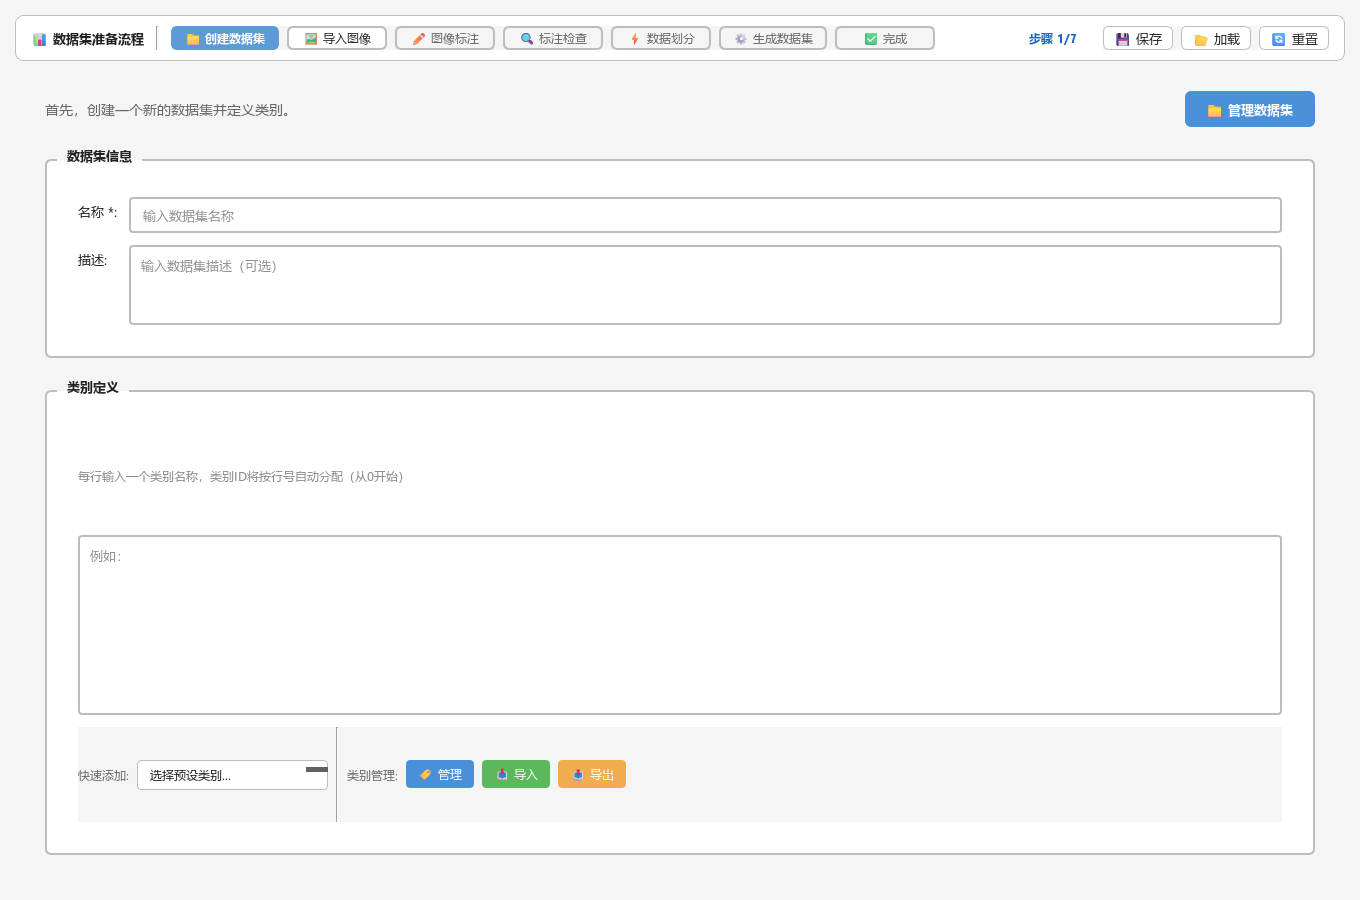
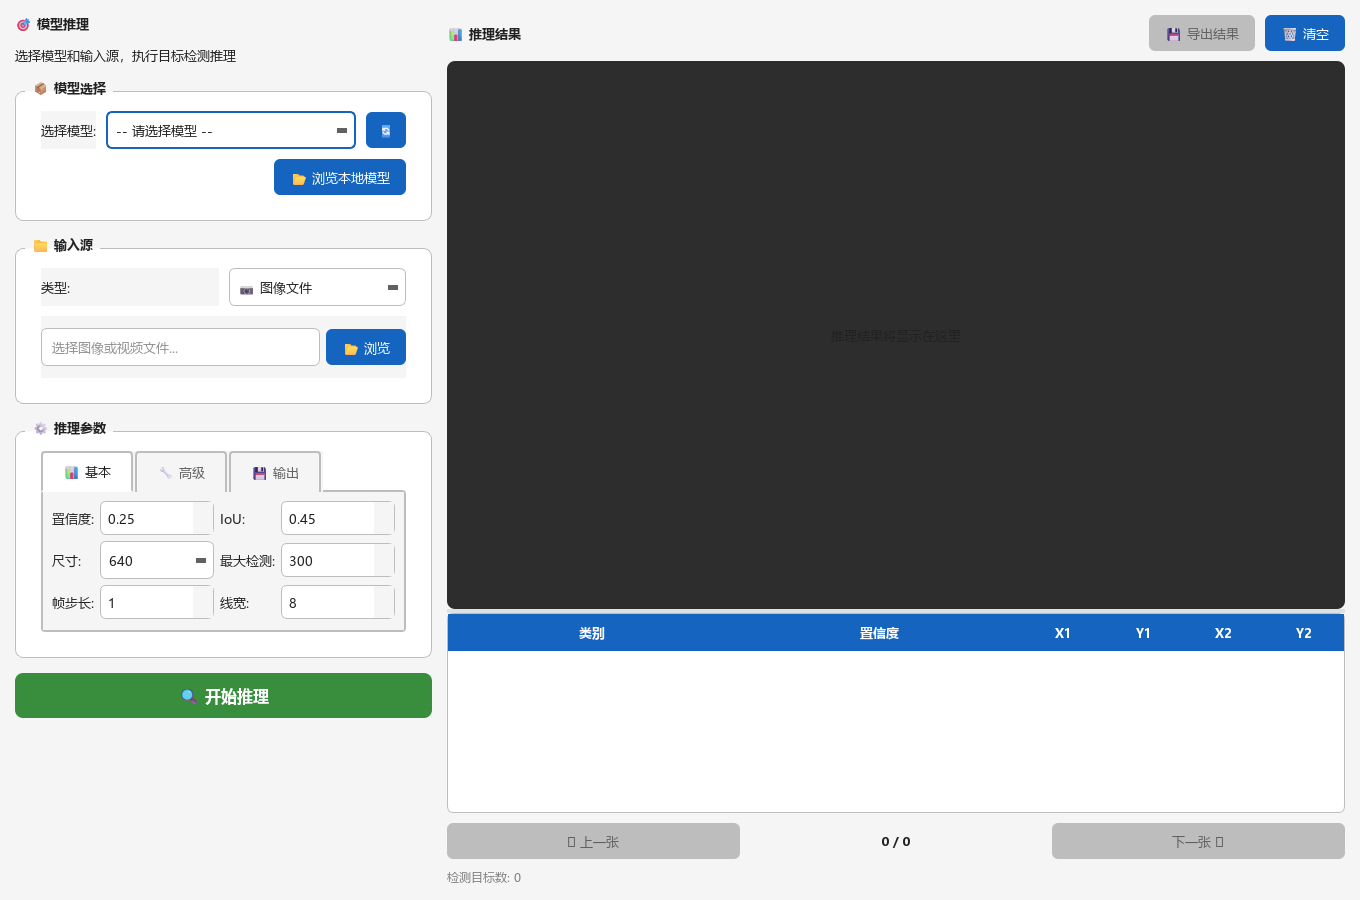
第一次验证训练流程时,我会先把目标定为:程序能读取数据、完成少量轮次并留下可解释的结果。等链路稳定,再逐步增加模型规模和训练时间。配套工作台将环境检查、参数设置、训练过程和完成结果拆成不同页面,适合沿着这个顺序定位问题。
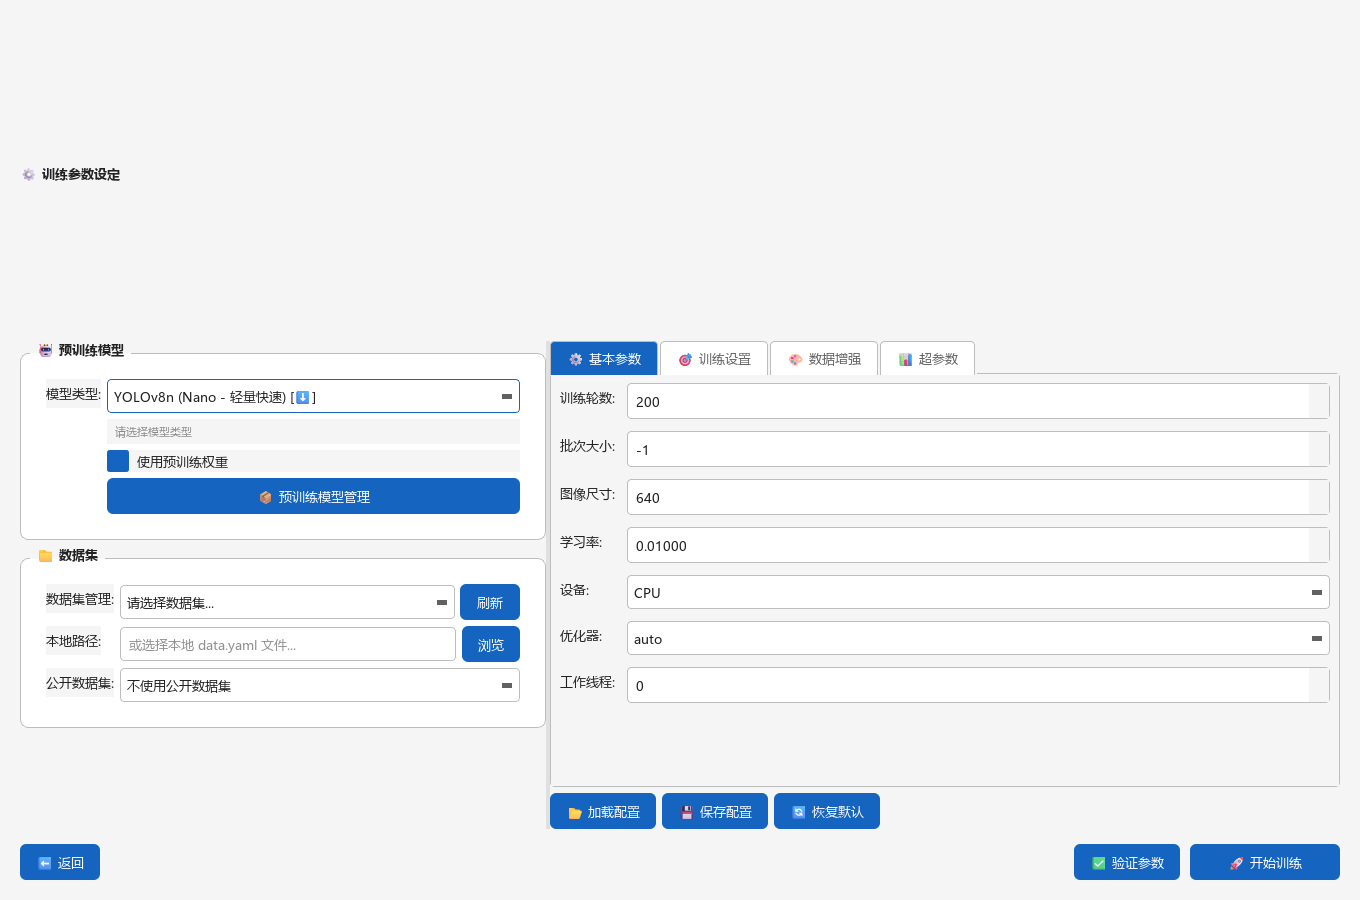
1. 确认模型、数据和任务类型能够对上
选择模型前,先检查 data.yaml 的图片路径、类别数量与标签格式,再确认权重对应的模型和任务。项目中提供了多个本地权重文件,但文件名相似不代表它们一定能被同一个旧版 Ultralytics 正确加载。
用于验证流程的数据量可以较小,但应同时覆盖训练集和验证集,并包含实际要识别的类别。先预览数据,再启动任务,通常比训练结束后才发现类别顺序不一致更省时间。
2. 给第一次训练设定较小的验证配置
下面用三轮、较小 batch 和较小图片尺寸说明验证参数。命令需在已安装相应依赖、准备好数据和可信权重的环境中运行;它是操作示例,本次文章发布没有代替读者执行模型训练。
Windows 初次排错时可以先将 workers 设为 0,减少多进程数据加载引入的变量。CPU 验证通过后,再切换到已确认可用的 GPU,逐项增加 batch 或图片尺寸。不要把自动选择设备理解为驱动和运行环境一定正确。
from ultralytics import YOLO

def main():
    model = YOLO('weights/yolov8n.pt')
    model.train(
        data='workspace/datasets/demo/data.yaml',
        epochs=3,
        batch=2,
        imgsz=320,
        device='cpu',
        workers=0,
        project='runs/train',
        name='smoke_test',
    )

if __name__ == '__main__':
    main()
3. 观察实际输出,不只看进度条
工作台训练页面包含从 results.csv 读取指标和曲线的逻辑。排错时应同时核对训练日志、输出目录和 CSV 是否持续更新,并确认界面展示的是当前实验。界面能够打开,不能说明模型已经训练成功。
先确认至少完成一轮、写出结果文件并能重新读取权重,再分析精确率、召回率和 mAP。不同版本可能使用不同列名,读取脚本应检查 CSV 表头,不要写死一套列名后把缺失数据直接显示成 0。
4. 分清 best.pt、last.pt 与断点续训
常见训练输出中,best.pt 用于保存训练器按当前评价标准选出的较优权重,last.pt 对应最后保存的检查点。具体保存条件以训练器版本及配置为准,不能仅凭文件名判断它已经适合业务部署。
配套训练模块包含检查点查找与恢复入口。准备恢复前,应确认检查点来自哪次实验、数据和类别映射是否一致,以及所需的训练状态是否完整。若只是拿权重重新开始一项实验,应把它与恢复原实验区分开,并保存新的实验记录。
5. 评估先固定口径,再比较参数
调参时尽量只改变一组关键变量,例如保持验证集不变,只比较两种 batch 或图片尺寸,并同时记录解释器、依赖版本、数据版本和设备。若模型与数据划分一起变动,就很难判断指标变化来自哪里。
验证集用于选择与调整方案,独立测试集用于后续评估。要同时查看误检、漏检和典型失败图片,而不是只追求单个汇总数字。小样本流程跑通后,仍需要按目标场景扩大验证;本文没有提供未经实测的准确率或速度承诺。
对应源码模块与配套项目
本文结合本次整理源码编写,主要对应:gui/widgets/training_widget.py、gui/widgets/evaluation_widget.py、core/config.py。
项目介绍、界面截图与资料清单:桌面视觉模型训练与推理一体化工作台。